การพัฒนาของ AI กำลังเปลี่ยนโฉมหน้าธุรกิจไทยอย่างรวดเร็วครับ องค์กรจำนวนไม่น้อยกำลังนำข้อมูลลูกค้าไปใช้เป็น “เชื้อเพลิง” ในการฝึกและปรับแต่งโมเดล เพื่อให้บริการดีขึ้น คาดการณ์แม่นยำขึ้น และลดต้นทุน แต่คำถามที่ผู้บริหาร DPO และฝ่ายกฎหมายถามกันบ่อยที่สุดคือ…
“เราทำแบบนี้แล้วจะผิดกฎหมาย PDPA หรือเปล่า?”
คำตอบสั้น ๆ คือ ไม่ผิดโดยอัตโนมัติ แต่มีความเสี่ยงสูงมาก ถ้าทำโดยไม่วางแผนและไม่มีระบบควบคุมที่ชัดเจนครับ PDPA ไม่ได้ห้าม AI แต่ห้ามการประมวลผลข้อมูลส่วนบุคคลโดยไม่มีฐานทางกฎหมายรองรับ หรือนำไปใช้ผิดวัตถุประสงค์ที่แจ้งลูกค้าไว้ตั้งแต่แรก (ซึ่งหลายองค์กรยังมองข้ามจุดนี้อยู่บ่อย ๆ)
ความขัดแย้งที่องค์กรไทยกำลังเผชิญ
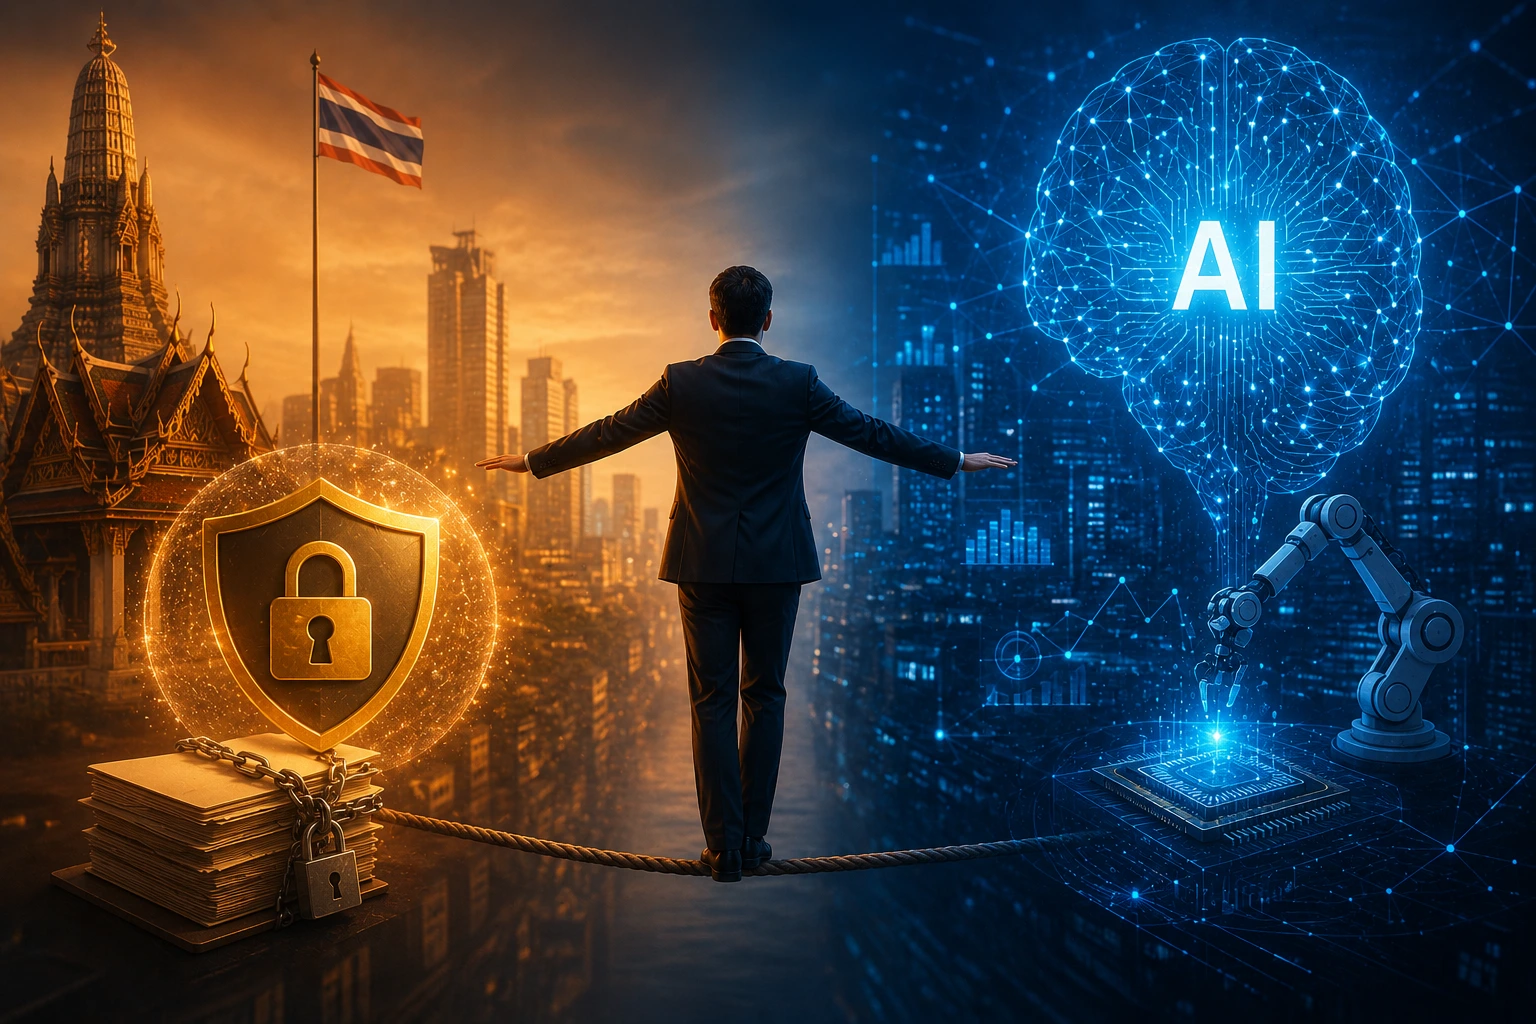
ผลคือ ข้อมูลที่เก็บมาเพื่อ “ส่งสินค้า” หรือ “ทำธุรกรรม” ไม่สามารถนำไปเทรน AI ได้ทันทีโดยอัตโนมัติ ถ้าทำโดยไม่แจ้งหรือขอความยินยอมใหม่ ถือเป็นการละเมิดมาตรา 21 ทันที
ปัญหายิ่งซับซ้อนขึ้นเมื่อข้อมูลลูกค้าถูกเก็บกระจายอยู่ในหลายระบบ และทีมพัฒนา AI ดึงข้อมูลมาใช้โดยไม่รู้ตัวว่ามีข้อมูลส่วนบุคคลปะปนอยู่ (จากประสบการณ์ที่เราเจอบ่อย ๆ นี่คือช่องโหว่ที่เกิดขึ้นโดยไม่ตั้งใจจริง ๆ)
ฐานทางกฎหมายที่ใช้ได้จริง
ในกฎหมาย PDPA นั้นมีสองฐานหลักที่องค์กรไทยนิยมพิจารณานำมาใช้นั้นคือ
ฐานความยินยอม (Consent) ปลอดภัยที่สุด โดยเฉพาะข้อมูล Sensitive Data เช่น ใบหน้า สุขภาพ หรือศาสนา ต้องขอ Explicit Consent แยกชัดเจนจากเงื่อนไขการใช้บริการทั่วไป และลูกค้าต้องสามารถถอนได้ง่าย
ฐานประโยชน์โดยชอบด้วยกฎหมาย (Legitimate Interest) ทำได้ แต่ยากและเสี่ยงครับ ต้องทำ Legitimate Interest Assessment (LIA) พิสูจน์ให้ได้ว่าประโยชน์ขององค์กรมีน้ำหนักมากกว่าสิทธิความเป็นส่วนตัวของลูกค้า ในทางปฏิบัติ การอ้างฐานนี้เพื่อเทรน AI เชิงพาณิชย์มักถูกตั้งคำถามจาก สคส. อยู่บ่อยครั้ง
คำแนะนำที่เราเห็นว่าปลอดภัยที่สุดสำหรับองค์กรไทย ก็คือ ควรทำ Data Anonymization ให้ข้อมูล “ไม่สามารถระบุตัวตนได้อีก” ก่อนนำไปใช้ครับ จะช่วยลดความเสี่ยงได้อย่างมีนัยสำคัญ
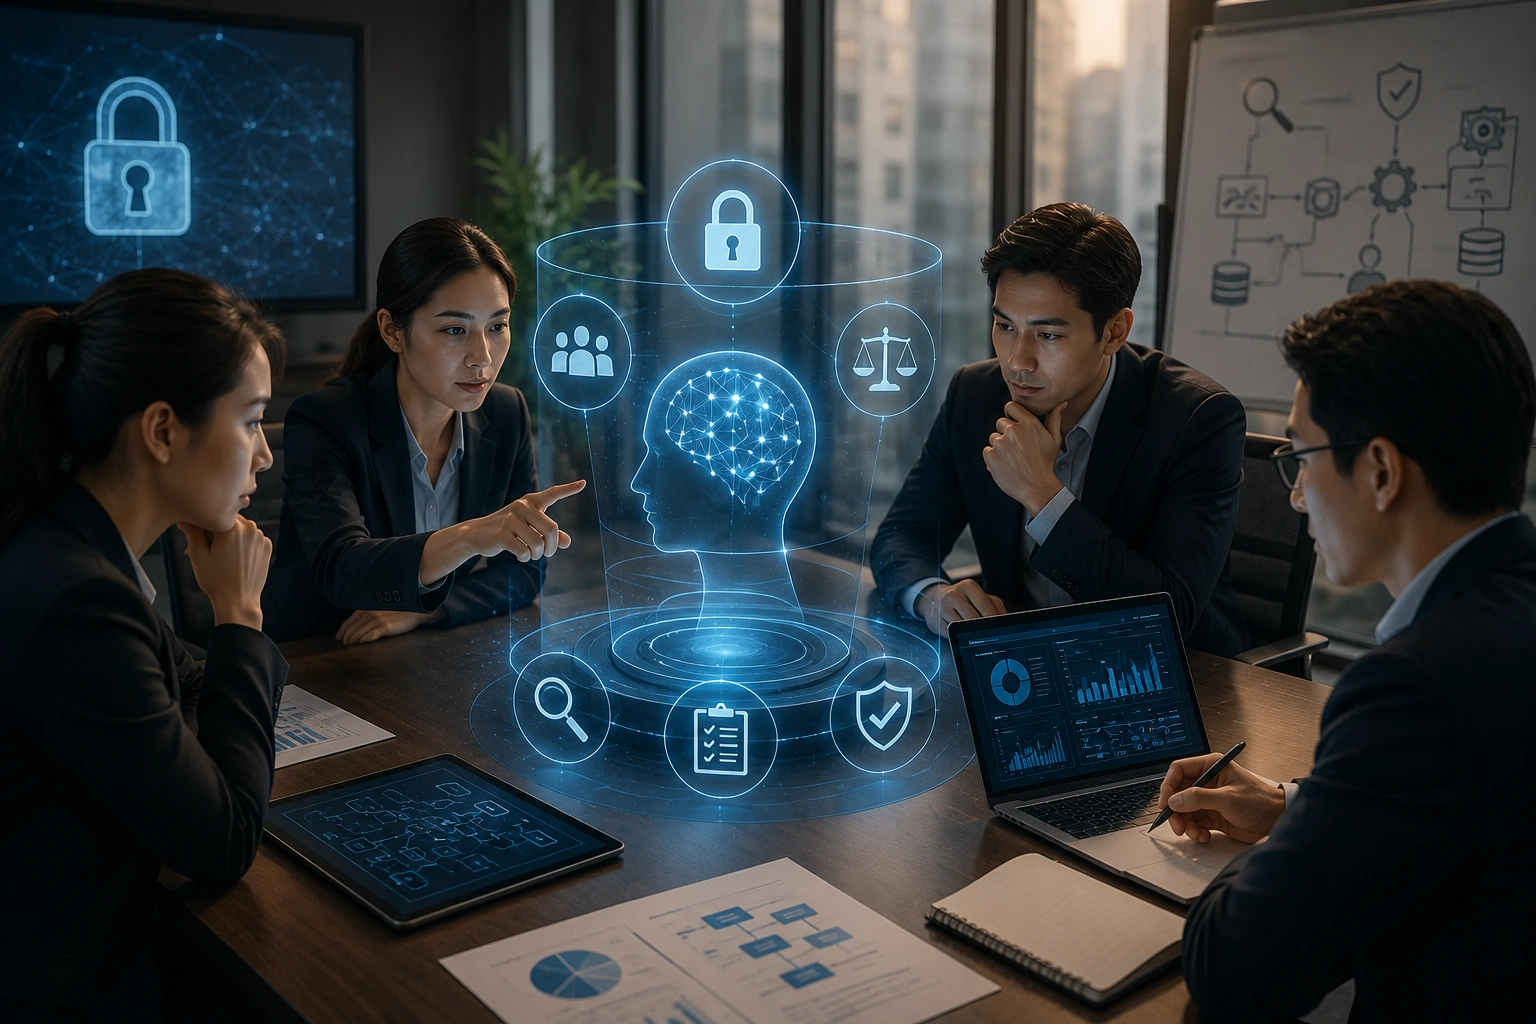
DPIA คือเครื่องมือที่องค์กรควรมีตั้งแต่เริ่มต้น
สำหรับโปรเจกต์ AI ที่มีความเสี่ยงสูง เช่น Chatbot ที่ดึงประวัติลูกค้า ระบบ Credit Scoring หรือ Facial Recognition องค์กรควรทำ Data Protection Impact Assessment (DPIA) ตั้งแต่ขั้นตอนออกแบบ
ร่างแนวปฏิบัติการคุ้มครองข้อมูลส่วนบุคคลในการพัฒนาและใช้ประโยชน์จากปัญญาประดิษฐ์ ของ PDPC (กุมภาพันธ์ 2569) ชี้ชัดว่า องค์กรต้องสามารถแสดงให้เห็นว่าได้ประเมินความเสี่ยงแล้วครับ โดยเฉพาะในกรณีที่มีการใช้ข้อมูลปริมาณมากหรือข้อมูล Sensitive
Data Anonymization รู้ว่าต้องทำแต่ทำอย่างไร
การทำให้ข้อมูลเป็นนิรนามอย่างแท้จริง (ไม่ใช่แค่เปลี่ยนชื่อเป็นรหัส) จะทำให้ข้อมูลพ้นจากขอบเขต PDPA ได้ เทคนิคที่ใช้ได้จริงในธุรกิจไทย ได้แก่
Data Shuffling
การบิดเบือนตัวเลขแบบสุ่ม (เช่น เงินเดือน ยอดซื้อ)
Data Generalization
การแปลงอายุเป็นช่วงอายุ หรือที่อยู่เป็นรหัสไปรษณีย์
Behavioral Clustering
การวิเคราะห์เป็นกลุ่มพฤติกรรมแทนการวิเคราะห์รายบุคคล
ข้อควรระวัง อย่าหลงเชื่อว่า Anonymization แล้วจะปลอดภัย 100% นะครับ ในยุค Generative AI ยังมีความเสี่ยง Reverse-engineering อยู่ ควรทำควบคู่กับมาตรการความปลอดภัยอื่น ๆ อย่างต่อเนื่อง เนื่องจาก Data เวลาแยกส่วนก็ไม่รู้หรือเดาไม่ได้ว่าใครเป็นใครแต่เมื่อนำมาร่วมแล้วสามารถชี้ไปที่เจ้าของข้อมูลนั้นๆได้เลย ต้องระวังมากๆโดยเฉพาะข้อมูลประเภท Sensitive Data ครับ
ความท้าทายเรื่อง
Right to Erasure VS Machine Unlearning
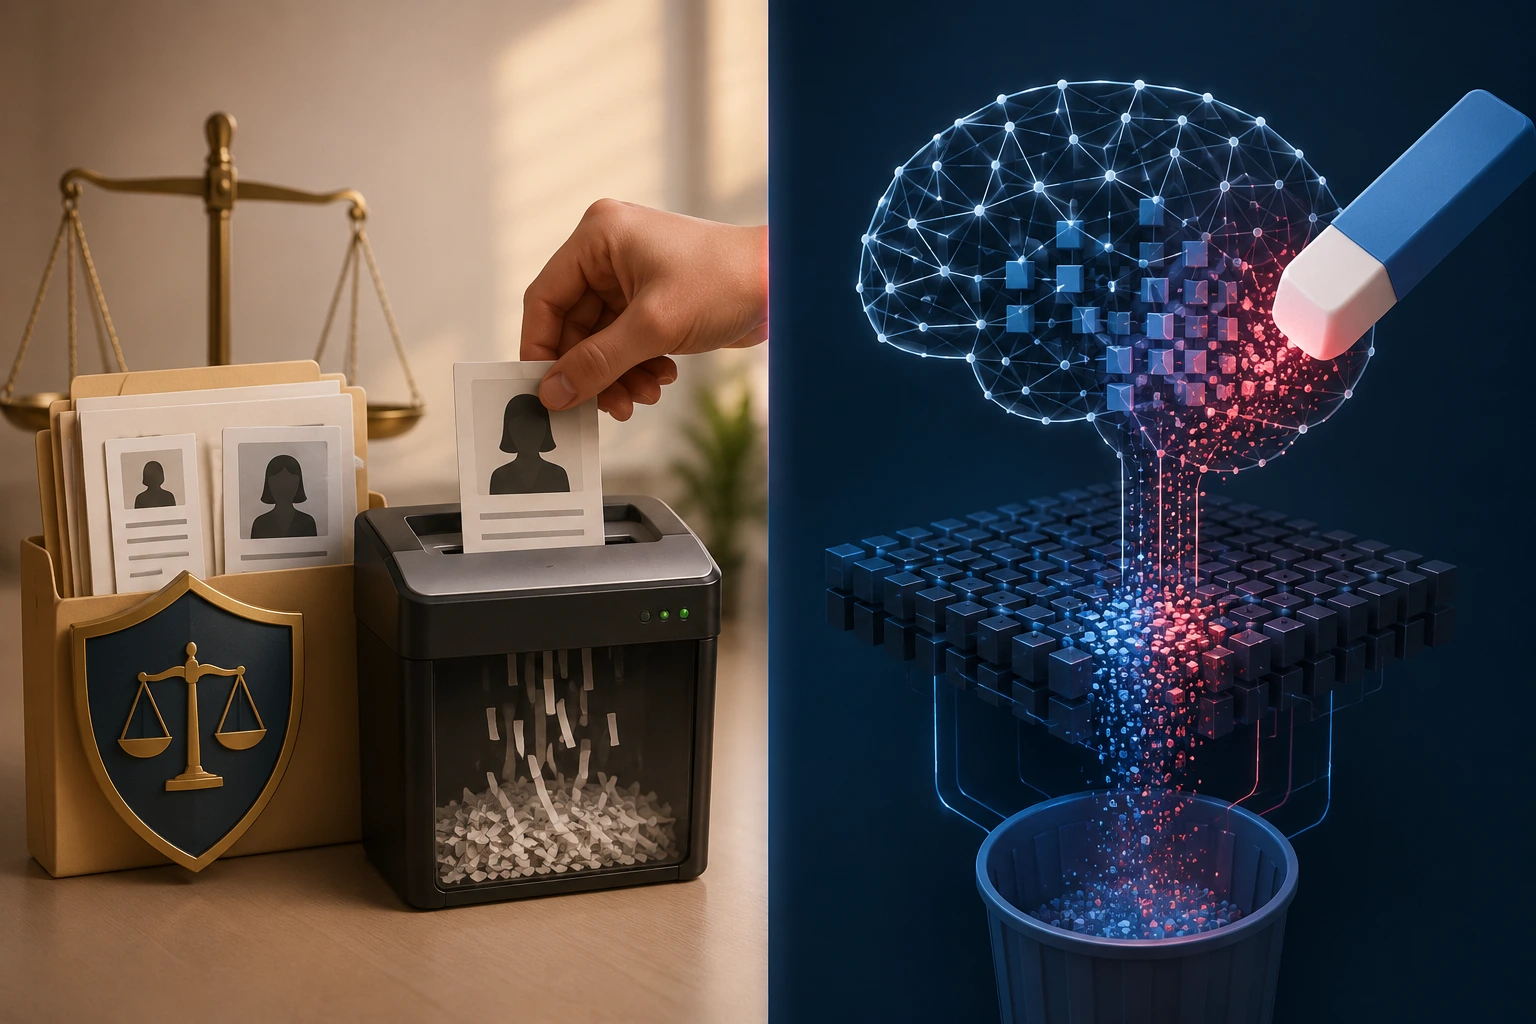
เมื่อลูกค้าขอใช้สิทธิลบข้อมูล (มาตรา 33) แต่ข้อมูลนั้นถูกนำไปเทรนอยู่ในโมเดล AI แล้ว การ “ลบ” จะทำได้ยากมากครับ เพราะข้อมูลถูกแปลงเป็น Weight และ Parameter นับล้านตัว
Machine Unlearning เป็นเทคโนโลยีที่กำลังพัฒนา แต่ยังไม่พร้อมเป็นคำตอบหลักในตอนนี้ จากมุมมองของเรา วิธีที่ดีที่สุดในปัจจุบันคือ ป้องกันตั้งแต่ต้น ด้วยการทำ Anonymization ก่อนนำข้อมูลเข้าโมเดล
อย่าลืมสัญญากับผู้ให้บริการภายนอก (DPA)
หลายองค์กรใช้บริการ SaaS AI หรือ Cloud AI จากภายนอก ร่างแนวปฏิบัติของ PDPC เน้นย้ำชัดเจนว่า ต้องมี Data Processing Agreement (DPA) ที่ระบุข้อห้ามไม่ให้ผู้ให้บริการนำข้อมูลของเราไปเทรนหรือปรับปรุงโมเดลของเขา รวมถึงกำหนดให้ลบข้อมูลหลังสิ้นสุดสัญญา และองค์กรมีสิทธิตรวจสอบความปลอดภัยได้
AI Governance Policy นโยบายนี้สำคัญมาก
ทางสำนักงานพัฒนาธุรกรรมทางอิเล็กทรอนิกส์(ETDA) ได้ออก AI Governance Guideline for Executives ตั้งแต่ปี 2566 และร่างแนวปฏิบัติของ PDPC ก็ย้ำเรื่องนี้ชัดเจนครับ องค์กรควรมีคณะกรรมการกำกับดูแล AI ข้ามสายงาน มีนโยบาย Acceptable Use ที่ชัดเจน (ห้ามพนักงานป้อนข้อมูลลูกค้าเข้าเครื่องมือ GenAI สาธารณะ) มี Audit Trail และมี Human Oversight สำหรับการตัดสินใจที่มีผลกระทบสำคัญ (ลองดูในองค์กรของเราว่ามีคุยกันเรื่องนี้หรือยังครับ)
บทเรียนจากกรณีจริงปรับจริงในไทย
บริษัท E-commerce ขนาดใหญ่ถูกปรับรวม 7 ล้านบาท เพราะไม่มี DPO มาตรการความปลอดภัยไม่เพียงพอ และรายงาน Breach ช้า
บริษัทขายของเล่นถูกปรับ 3 ล้านบาท (ฝั่ง Data Processor) เพราะระบบถูกแฮก
โรงพยาบาลถูกปรับกว่า 1.2 ล้านบาท เพราะเวชระเบียนถูกจัดการไม่ถูกต้อง
ตัวอย่างเหล่านี้แสดงให้เห็นว่า แม้ระบบธรรมดาก็ปรับหลักล้านได้แล้วครับ ถ้าเป็น AI ที่ดึงข้อมูลมหาศาล ความเสี่ยงยิ่งสูงกว่า
5 ขั้นตอนที่องค์กรไทยควรทำทันที
อัปเดต Privacy Policy ให้ระบุชัดเจนเรื่องการใช้ข้อมูลกับ AI
สร้างมาตรฐาน Data Anonymization เป็นส่วนหนึ่งของ Data Pipeline
ทำ DPIA สำหรับทุกโปรเจกต์ AI ที่มีความเสี่ยงสูง
ปรับปรุง DPA กับผู้ให้บริการ AI ภายนอกให้เข้มงวด
สร้างนโยบายและทีม AI Governance ระดับองค์กร และฝึกอบรมพนักงานอย่างต่อเนื่อง
การนำ AI มาใช้อย่างปลอดภัยและสอดคล้องกับ PDPA ไม่ใช่เรื่องที่ทำได้ด้วยตัวเองง่าย ๆ โดยเฉพาะเมื่อต้องคำนึงถึงทั้งความเสี่ยงทางกฎหมาย ความมั่นคงปลอดภัยของข้อมูล และความเป็นไปได้ทางเทคนิค
ไซเบอร์เนติกส์ พลัส จำกัด พร้อมเป็นพันธมิตรที่องค์กรของคุณไว้วางใจครับ ด้วยทีมงานผู้เชี่ยวชาญด้าน การคุ้มครองข้อมูลส่วนบุคคล (PDPA) และ ความมั่นคงปลอดภัยไซเบอร์ ที่มีประสบการณ์จริงในการช่วยองค์กรไทยทั้งขนาดกลางและขนาดใหญ่
บริการที่เราพร้อมสนับสนุน ได้แก่
- การประเมินช่องว่าง (Gap Assessment) และจัดทำ AI Governance Policy ตามแนวทาง ETDA และร่างแนวปฏิบัติของ PDPC
- การออกแบบและนำ Data Anonymization ไปใช้จริงในกระบวนการทำงาน
- การทำ DPIA และ Legitimate Interest Assessment (LIA) สำหรับโปรเจกต์ AI
- การทบทวนและจัดทำ Data Processing Agreement (DPA) กับผู้ให้บริการ AI ภายนอก
- การฝึกอบรมพนักงานและ DPO เรื่อง PDPA + AI Security
- การให้คำปรึกษาและติดตามการบังคับใช้กฎหมายอย่างต่อเนื่อง
เราเข้าใจดีว่าทุกองค์กรมีบริบทและความท้าทายที่แตกต่างกันครับ ทีมงานของเราพร้อมนั่งลงคุยและออกแบบแนวทางที่เหมาะสมที่สุดสำหรับธุรกิจของคุณ เพื่อสร้าง Digital Trust ที่ยั่งยืน
สนใจรับคำปรึกษาเบื้องต้นหรือจัด Workshop ภายในองค์กร ติดต่อทีมงาน ไซเบอร์เนติกส์ พลัส จำกัด ได้เลยครับ
เราพร้อมช่วยให้องค์กรของคุณใช้ประโยชน์จาก AI ได้อย่างมั่นใจ ปลอดภัย และสอดคล้องกับกฎหมายไทยครับ