เวลาระบบสำคัญของบริษัทล่ม คำถามแรกที่ผู้บริหารถามมักไม่ใช่เรื่อง Server, Storage หรือ Network ครับ แต่เป็นคำถามที่ตรงกับธุรกิจมากกว่า “ระบบจะกลับมาใช้ได้เมื่อไหร่?” และอีกคำถามที่มักตามมาติด ๆ คือ “ข้อมูลจะหายไปแค่ไหน?”
สองคำถามนี้ดูเหมือนง่าย แต่จริง ๆ แล้วคือหัวใจของ Disaster Recovery เลยครับ เพราะมันนำไปสู่คำสำคัญสองคำที่ทีม IT คุ้นกันดี คือ RTO และ RPO
หลายองค์กรมี Backup อยู่แล้ว และมักรู้สึกว่า ถ้าเกิดเหตุขึ้นก็น่าจะกู้ระบบกลับมาได้ แต่ในความเป็นจริง การมี Backup กับการทำให้ธุรกิจกลับมาทำงานได้ ไม่ใช่เรื่องเดียวกัน
- เรามีไฟล์ Backup ไม่ได้แปลว่า Application จะเปิดขึ้นมาได้ทันที
- Database กลับมาได้ ก็ไม่ได้แปลว่า User จะกลับเข้าใช้งานได้ครบทุกส่วน
- และบางครั้ง Restore ได้จริง แต่ใช้เวลานานกว่าที่ธุรกิจรับได้มาก
ตรงนี้เองที่ BCP และ DR เข้ามามีบทบาทครับ
เมื่อองค์กรเริ่มกำหนดได้แล้วว่า ระบบหนึ่ง ๆ ควรกลับมาเร็วแค่ไหน และยอมเสียข้อมูลย้อนหลังได้เท่าไร ขั้นต่อไปคือการออกแบบว่า เราควรเตรียมระบบสำรองไว้พร้อมแค่ไหน
บางระบบอาจยอมให้ใช้เวลาหลายชั่วโมงหรือเป็นวันในการสร้าง Environment และ Restore ข้อมูลกลับมาใหม่ ขณะที่บางระบบหยุดแทบไม่ได้ จึงต้องมี Infrastructure สำรองเตรียมพร้อมอยู่แล้ว และสามารถสลับไปใช้งานได้อย่างรวดเร็วเมื่อระบบหลักมีปัญหา
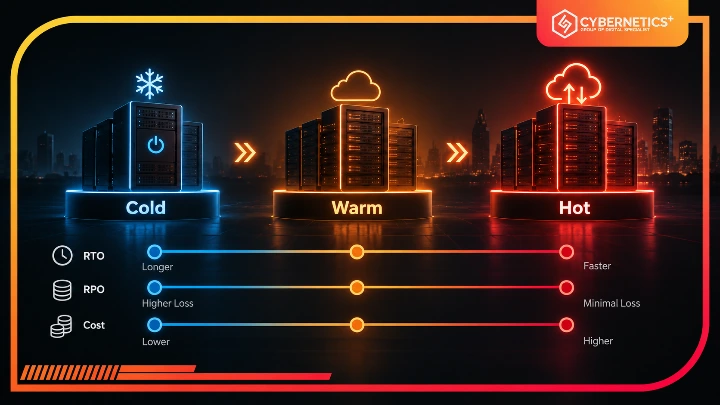
ระดับความพร้อมของระบบสำรองจึงมักแบ่งออกเป็น 3 รูปแบบหลัก คือ Cold Site, Warm Site และ Hot Site
ถ้ามองแบบง่าย ๆ ความต่างของทั้งสามแบบไม่ได้อยู่แค่เทคโนโลยี แต่คือ เราจะลงทุนเตรียมความพร้อมไว้ล่วงหน้ามากแค่ไหน เพื่อแลกกับเวลาที่ใช้ในการ Recover ระบบเมื่อเกิดเหตุ
ดังนั้นคำถามสำคัญจึงไม่ใช่ “Cold, Warm หรือ Hot Site แบบไหนดีที่สุด?” แต่ควรเป็น “ระบบนี้สำคัญกับธุรกิจแค่ไหน เรารอให้ระบบกลับมาได้นานเท่าไร และยอมเสียข้อมูลย้อนหลังได้มากแค่ไหน?”
เมื่อได้คำตอบสามข้อนี้แล้ว การเลือกว่าระบบไหนควรใช้ Cold Site, Warm Site หรือ Hot Site ก็จะมีเหตุผลทางธุรกิจรองรับมากขึ้นครับ
ก่อนเลือก DR Site ต้องเริ่มจาก RTO และ RPO
ผมชอบอธิบายสองคำนี้กับคนที่ไม่ได้อยู่สาย IT แบบง่าย ๆ ครับ
RTO - เรายอม “รอระบบให้กลับมาปกติ” ได้นานแค่ไหน
RTO หรือ Recovery Time Objective คือระยะเวลาที่องค์กรยอมรับได้ว่าระบบจะหยุดทำงานหลังเกิดเหตุ สมมติว่า ERP ของบริษัทมี RTO 4 ชั่วโมง ความหมายก็คือ ถ้า ERP หยุดตอน 10 โมง องค์กรตั้งเป้าว่าประมาณบ่าย 2 ระบบควรกลับมาใช้งานได้ แต่แน่นอนครับ ไม่ใช่ทุกระบบต้องมี RTO เท่ากัน เว็บไซต์บริษัทอาจหยุดได้หนึ่งวันโดยไม่เกิดผลกระทบมากนัก แต่ถ้าเป็น POS ระบบรับ Order หรือระบบที่ผูกกับ Production อาจหยุดได้เพียงไม่กี่ชั่วโมง
บางธุรกิจอาจบอกว่า “ระบบนี้หยุดไม่ได้เลย”
ซึ่งตรงนั้นก็ต้องคุยกันต่อว่า “ไม่ได้เลย” หมายถึงกี่นาที เพราะในทางออกแบบระบบ คำตอบนี้ส่งผลต่อต้นทุนโดยตรงครับ
RPO - เรายอม “เสียข้อมูลย้อนหลัง” ได้แค่ไหน
RPO หรือ Recovery Point Objective คือปริมาณข้อมูลย้อนหลังที่องค์กรยอมสูญเสียได้เมื่อเกิดเหตุ สมมติ RPO คือ 1 ชั่วโมง และระบบเสียตอน 15.00 น. Recovery Point ที่เราหวังว่าจะมี ก็ควรย้อนกลับไปไม่เกินประมาณ 14.00 น. ดังนั้นถ้าจำสั้น ๆ
RTO = ระบบต้องกลับมาเร็วแค่ไหน
RPO = ยอมเสียข้อมูลย้อนหลังได้แค่ไหน
และตรงนี้มักเป็นช่วงที่ฝ่าย IT กับฝ่ายธุรกิจต้องคุยกันเยอะที่สุดครับ
เพราะทุกคนอยากได้ RTO/RPO ใกล้ศูนย์ แต่พอเริ่มคุยเรื่อง Architecture, Replication, Secondary Infrastructure, Network และค่าใช้จ่าย คำว่า “ใกล้ศูนย์” จะเริ่มมีราคาของมันขึ้นมาทันที เพราะฉะนั้นแนวทางที่ถูกต้องไม่ควรเริ่มจากว่า “เราอยากได้ Hot Site” แต่ควรเริ่มจาก “ถ้าระบบนี้หยุด ธุรกิจเสียอะไรบ้าง?”
NIST เองก็วางแนวคิดคล้ายกัน คือควรเริ่มจาก Business Impact Analysis แล้วค่อยกำหนด Recovery Strategy ให้สอดคล้องกับความสำคัญของระบบ
แล้ว Cold, Warm และ Hot Site ต่างกันตรงไหน?
ถ้ามองแบบไม่ซับซ้อนมาก สามคำนี้ก็คือระดับ “ความพร้อม” ของระบบสำรองครับ
Cold Site พร้อมน้อยที่สุด แต่ค่าใช้จ่ายก็ต่ำที่สุด
Warm Site เตรียมระบบไว้บางส่วนแล้ว
ส่วน Hot Site เตรียม Infrastructure และระบบไว้พร้อมมากที่สุด เพื่อให้สลับไปใช้งานได้เร็วที่สุด
แต่มีเรื่องหนึ่งที่อยากแทรกไว้ตรงนี้ครับ Hot Site ไม่ได้แปลว่า Real-time เสมอไป ตรงนี้หลายคนเข้าใจปนกัน ระบบที่ทำ Real-time Mirroring อย่างเต็มรูปแบบจะใกล้กับแนวคิด Mirrored Site มากกว่า ซึ่งถือเป็นอีกระดับของการออกแบบระบบ
ดังนั้นอย่าเห็นคำว่า Hot แล้วตีความทันทีว่า RTO = 0 และ RPO = 0 ครับ มันยังขึ้นกับ Architecture อีกเยอะมาก
ถ้าสรุปแบบง่าย ๆ
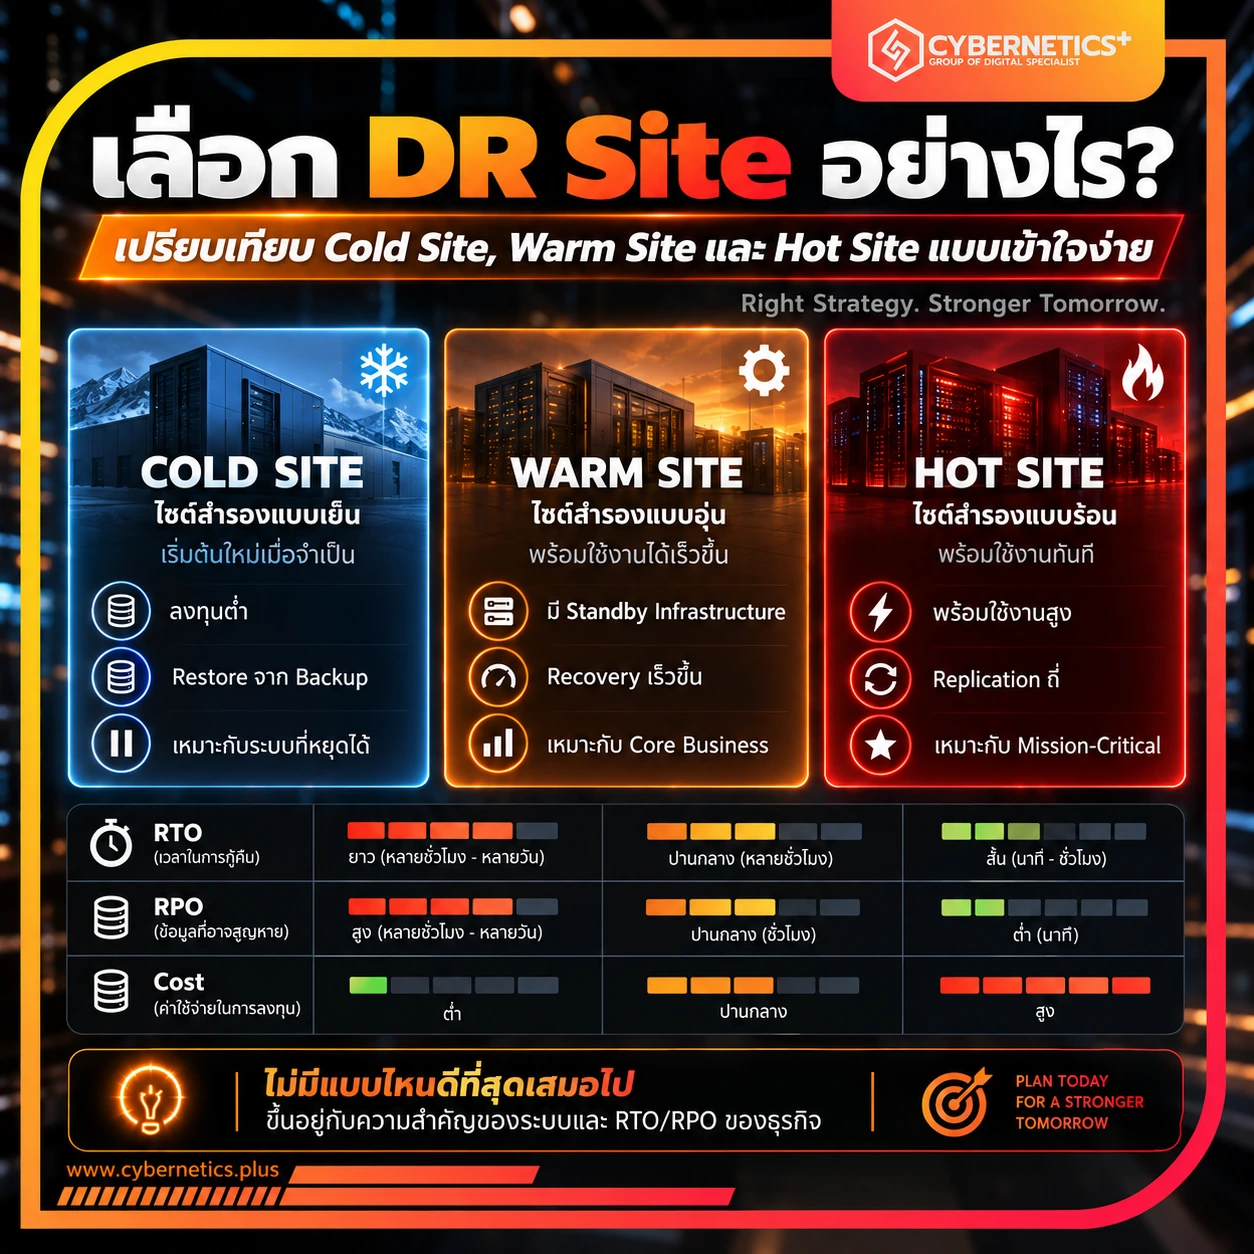
ประเด็น | Cold Site | Warm Site | Hot Site |
ความพร้อม | มี Backup และ Infrastructure สำหรับ Recover | มี Secondary Infrastructure เตรียม Standby | ระบบสำรองมีความพร้อมสูง |
Data | Restore จาก Backup เป็นหลัก | Backup + Periodic Replication | Replication ความถี่สูง / Near Real-Time ตามการออกแบบ |
RTO | ยาวที่สุด | ปานกลาง | สั้นที่สุด |
RPO | ขึ้นกับรอบ Backup | ลดลงตามรอบ Replication | ต่ำมากได้ |
ต้นทุน | ต่ำ | ปานกลาง | สูง |
เหมาะกับ | ระบบที่หยุดได้ | Core Business | Mission-Critical |
ตัวเลขจริงของ RTO/RPO ไม่ควรผูกตายตัวกับคำว่า Cold, Warm หรือ Hot นะครับ
เพราะสุดท้ายมันยังขึ้นกับ Database, Network, Application Dependency, ปริมาณข้อมูล และขั้นตอนของคนที่เข้ามา Recover ระบบด้วย
Cold Site - เหมาะกับระบบที่ “รอได้”
Cold Site เป็นรูปแบบที่ค่อนข้างตรงไปตรงมาครับ
เรามี Backup มี Infrastructure หรือ Environment สำหรับใช้ Recover แต่ไม่ได้เปิดระบบสำรองพร้อมทำงานตลอดเวลา เมื่อเกิดเหตุจริงจึงต้องมีขั้นตอนประมาณนี้ Provision Infrastructure
→ ติดตั้งระบบ
→ Restore Backup
→ Configure
→ Test
→ เปิดให้ User กลับมาใช้งาน
ข้อดีคือประหยัดครับ
แต่สิ่งที่ต้องแลกคือเวลา
ระบบประเภทนี้จึงมักเหมาะกับงานที่ไม่ใช่ Mission-Critical เช่น Internal Application บางตัว, Archive หรือระบบที่ธุรกิจยอมให้หยุดได้ช่วงหนึ่ง
สำหรับบริการ Disaster Recovery Protection - Cold Site ของ Cybernetics Plus รูปแบบนี้รวม BCP Framework, การกำหนด RTO/RPO, Recovery Runbook, Annual DR Drill และ Immutable Off-site Backup โดยจะสร้าง Environment และ Restore ระบบเมื่อเกิด Disaster จริง
บางบริษัทอาจฟังคำว่า Cold แล้วรู้สึกว่า “ดูธรรมดาไปหรือเปล่า” จริง ๆ ไม่จำเป็นครับ
ถ้าระบบนั้นหยุดหนึ่งวันแล้วธุรกิจยังเดินต่อได้ การลงทุน Hot Site ให้ระบบนั้นอาจไม่ใช่การลงทุนที่สมเหตุสมผลเท่าไร
Warm Site - จุดตรงกลางที่หลายองค์กรน่าจะคุ้นที่สุด
Warm Site จะขยับความพร้อมขึ้นมาอีกระดับครับ
แทนที่จะต้องสร้างทุกอย่างใหม่ตอนเกิดเหตุ เราจะเตรียม Secondary Infrastructure บางส่วนไว้แล้ว
ข้อมูลก็จะมีการ Replicate เป็นช่วง ๆ
เมื่อเกิดเหตุ กระบวนการ Recover จึงสั้นกว่า Cold Site มาก
ตรวจ Recovery Point
→ Activate Environment
→ Sync หรือ Restore ข้อมูลล่าสุด
→ Validate
→ เปิดใช้งาน
ระบบประเภท ERP, Warehouse Management, CRM หรือ Backend สำคัญของธุรกิจ มักเป็นกลุ่มที่ควรนำมาประเมินกับแนวทางแบบนี้
บริการ Warm Site ของ C+ ใช้ Standby Secondary Infrastructure ร่วมกับ Immutable Backup และ Periodic Data Replication เพื่อให้ Environment สำรองพร้อมนำขึ้นใช้งานได้เร็วกว่า Cold Site
(ส่วนตัวผมมองว่า Warm Site เป็นจุดที่น่าสนใจมากสำหรับองค์กรขนาดกลาง เพราะไม่ต้องจ่ายต้นทุนเท่าระบบที่ Active พร้อมกันตลอดเวลา แต่ Recovery Time ก็ไม่ได้ยาวจนธุรกิจต้องรอเป็นวัน)
แต่คำถามสุดท้ายก็ยังเหมือนเดิมครับ
ถ้าระบบหยุด 4 ชั่วโมง 8 ชั่วโมง หรือ 1 วัน เราเสียอะไร?
เพราะบางทีค่าเสียหายจาก Downtime หนึ่งครั้ง อาจมากกว่าค่า DR ทั้งปีเสียอีก
Hot Site - สำหรับระบบที่ธุรกิจแทบหยุดไม่ได้
Hot Site ขยับเรื่องความพร้อมขึ้นมาอีกขั้น
ฝั่ง DR จะมี Infrastructure ที่เตรียมพร้อมมากกว่า Warm Site และโดยปกติจะมีการทำ Replication ที่ถี่กว่า
บางระบบสามารถทำ Automated หรือ Semi-Automated Failover ได้
จึงเหมาะกับระบบอย่าง
E-Commerce
Financial Transaction
ระบบขายหน้าร้าน
Production System
Platform ที่มี Transaction จำนวนมาก
ระบบที่หยุดแล้วกระทบ Supply Chain โดยตรง
บริการ Hot Site ของ C+ ออกแบบให้รองรับ Near Real-Time Replication และ Automated/Semi-Automated Failover สำหรับระบบที่ต้องการลด Downtime ให้น้อยที่สุด
แต่ขอย้ำอีกครั้งครับ
Hot Site ไม่ได้แปลว่า Zero Downtime โดยอัตโนมัติ
ถ้าต้องการเข้าใกล้ Zero จริง ๆ Application, Database, Storage, Network รวมถึงวิธีการทำ Failover จะต้องออกแบบรองรับตั้งแต่ต้น
ซื้อ Infrastructure อย่างเดียวไม่พอครับ
มี Hot Site แล้ว ยังโดน Ransomware เล่นงานได้ไหม?
คำตอบคือ ได้ครับ ! และตรงนี้ผมคิดว่าเป็นประเด็นที่สำคัญกว่าการเลือก Cold, Warm หรือ Hot เสียอีก ลองสมมติเหตุการณ์หนึ่งดูครับ
วันจันทร์ ผู้โจมตีเข้ามาในระบบได้แล้ว แต่ยังไม่ทำอะไรให้เรารู้ตัว
วันอังคาร เริ่มกระจายตัวในระบบ
วันพุธ มีข้อมูลบางส่วนถูกแก้ไข
วันพฤหัส ระบบ Replication ก็ยังทำหน้าที่ของมันอย่างขยันขันแข็ง คือ Replicate ทุกอย่างไปฝั่ง DR
แล้ววันศุกร์ Ransomware ถึงเริ่ม Encrypt ระบบ
คำถามคือ
ข้อมูลที่ DR Site ของเราตอนนั้นเป็นข้อมูลที่เราต้องการ Recover จริงหรือเปล่า?
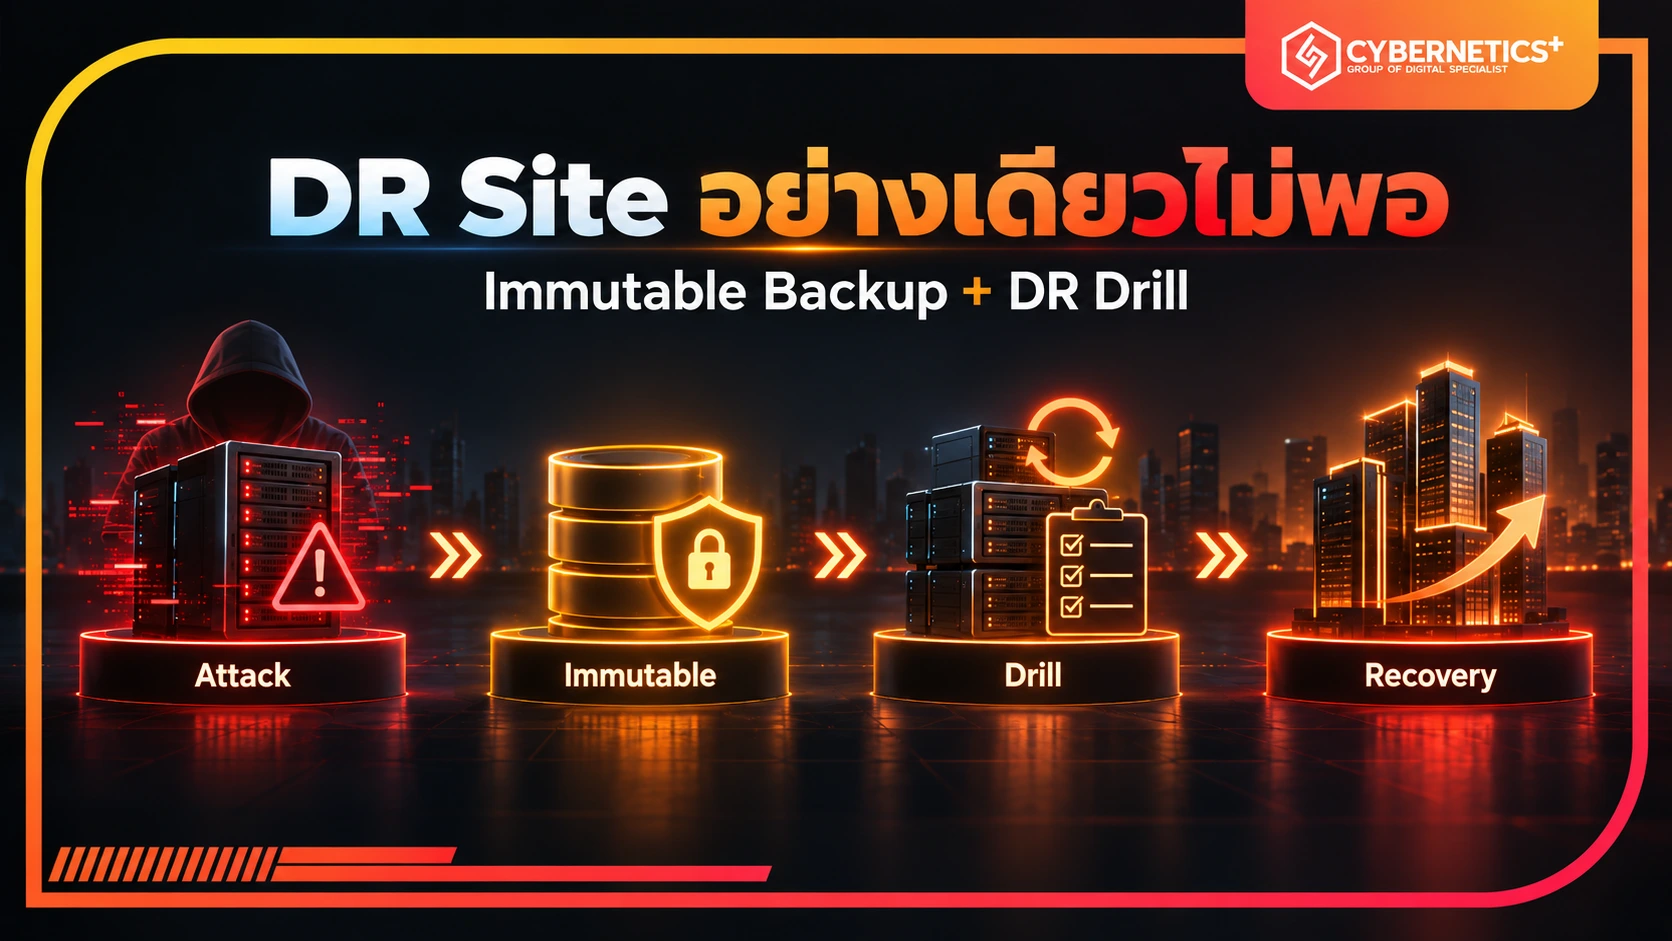
นี่แหละครับที่ทำให้ Disaster Recovery กับ Cyber Recovery เป็นคนละเรื่องกัน
DR ทำให้เรามี Infrastructure สำหรับกลับมาทำงาน
แต่ DR ไม่ได้แปลว่า Data ที่อยู่ในนั้น “สะอาด” โดยอัตโนมัติ
Immutable Backup สำคัญตรงไหน
Immutable Backup คือการทำ Recovery Copy ที่หลังจากสร้างแล้ว ไม่สามารถถูกแก้หรือลบได้ง่ายในช่วงเวลาที่กำหนด
แนวคิดนี้สำคัญกับ Ransomware มากครับ
เพราะ attacker ในยุคนี้ไม่ได้สนใจแค่ Production แล้ว
ถ้ามีเวลา เขาจะพยายามหา Backup Server, Storage หรือ Credential ที่ใช้จัดการ Backup ด้วย
ถ้าลบ Backup ได้ก่อน แล้วค่อย Encrypt Production เราก็แทบไม่มีทางเลือกเหลือ
ดังนั้น Cybernetics+ จึงใส่ Immutable Off-site Backup เข้าไปเป็นส่วนหนึ่งของ BCP/DR Service ทั้ง Cold, Warm และ Hot Site ด้วย
แต่ตรงนี้มีอีกประโยคหนึ่งที่อยากให้จำไว้ครับ
Immutable ไม่ได้แปลว่า Clean
สมมติ attacker เข้ามาวันจันทร์
เรา Backup วันอังคาร Backup วันอังคารอาจจะ Immutable จริง คือหลังจากนั้นใครก็แก้ไม่ได้
แต่ attacker หรือ Malware อาจอยู่ในระบบก่อน Backup แล้ว ดังนั้นการทำ Cyber Recovery ที่ดีจึงไม่ควรคิดแค่ว่า “มี Immutable Backup แล้วจบ” แต่ควรมองเป็นกระบวนการ
Multiple Recovery Points
→ Immutable / Isolated Backup
→ Integrity Verification
→ Malware Inspection
→ Restore
→ Validate
→ Return to Production
ตรงนี้เป็นอีกเหตุผลว่าทำไม “เก็บ Backup” กับ “Recover ธุรกิจ” ถึงไม่ใช่เรื่องเดียวกันครับ
Backup ผ่านทุกคืน ไม่ได้แปลว่า Restore ได้จริง
เรื่องหนึ่งที่เจอบ่อยมากคือ Backup Job ขึ้นสีเขียว Completed ทุกคืน
ไม่มี Error ทุกคนสบายใจ จนวันหนึ่ง Server เสียจริง
แล้วถึงพบว่า Restore Database ได้ แต่ Application เปิดไม่ได้
หรือ Application เปิดได้ แต่ต่อกับ Service ตัวอื่นไม่ได้
หรือบางครั้ง Restore ได้ครบหมด แต่ใช้เวลา 12 ชั่วโมง ขณะที่ผู้บริหารเข้าใจมาตลอดว่า “ระบบเราน่าจะกลับมาใน 2 ชั่วโมง”
เรื่องพวกนี้รู้ตอนวันเกิดเหตุไม่ได้ครับ มันต้องรู้ก่อน และวิธีเดียวที่จะรู้คือ ลอง Recover จริง
DR Drill เป็นส่วนที่จำเป็น
เวลาทำ DR Drill ผมมองว่าคำถามสำคัญไม่ใช่แค่ว่า “เปิดระบบขึ้นมาได้ไหม” แต่ต้องถามไปถึงว่า
ใครเป็นคนประกาศ Disaster?
ใครตัดสินใจ Failover?
Backup ที่เราจะใช้ Recover อยู่ตรงไหน?
ถ้า Recovery Point ล่าสุดใช้ไม่ได้ เราถอยไปไหน?
ระบบไหนต้องขึ้นก่อน?
Application นี้พึ่งพา Database หรือ API ตัวไหน?
ผู้ใช้งานจะกลับเข้าระบบอย่างไร?
ข้อมูลหลัง Restore ถูกต้องหรือเปล่า?
แล้วถ้า Production กลับมา เราจะ Failback อย่างไร?
คำถามเหล่านี้เป็นเรื่องของทั้ง Technology และคนครับ
Cybernetics+ จึงใส่ Annual DR Drill และ Recovery Runbook อยู่ใน BCP/DR Framework เข้าไปเป็นกิจกรรมหลักด้วยครับ
เพราะสุดท้ายแล้ว DR Plan ที่สวยมากบนกระดาษ แต่ไม่เคยมีใครลองทำจริง ผมก็ยังไม่ค่อยกล้าเรียกว่า “พร้อม” เท่าไรครับ
แล้วจะเลือก Cold, Warm หรือ Hot อย่างไร?
ถ้าถามผม ผมจะไม่เริ่มจากคำถามว่า “มีงบเท่าไร?”
แต่จะเริ่มจาก “ถ้าระบบนี้หายไปพรุ่งนี้ ธุรกิจเราทำงานต่อได้ไหม?”
จากนั้นค่อยแบ่งระบบเป็น Tier
Tier 1 - Mission Critical
หยุดแล้วธุรกิจแทบเดินต่อไม่ได้ เช่น ระบบ Transaction, Production, E-Commerce หรือระบบที่เชื่อมกับ Supply Chain โดยตรง กลุ่มนี้ควรพิจารณา Hot Site หรือ Architecture ที่รองรับ RTO/RPO ต่ำมาก
Tier 2 - Business Critical
หยุดได้บ้าง แต่ไม่ควรเป็นวัน ERP, CRM, Warehouse หรือ Backend สำคัญหลายระบบมักอยู่กลุ่มนี้ Warm Site เป็นหนึ่งในทางเลือกที่ควรนำมาประเมิน
Tier 3 - Supporting System
หยุดได้เป็นระยะเวลานานกว่า Cold Site อาจเหมาะและคุ้มค่ากว่า และองค์กรไม่จำเป็นต้องเลือกแบบเดียวทั้งบริษัทครับ บริษัทหนึ่งอาจมี Hot Site สำหรับระบบขาย Warm Site สำหรับ ERP
Cold Site สำหรับ Internal Application
ซึ่งในความเป็นจริง ผมคิดว่านี่เป็นภาพที่สมเหตุสมผลกว่าการพยายามทำทุกอย่างให้เป็น Hot Site เสียอีก
Cybernetics+ มอง DR เป็นส่วนหนึ่งของ Cyber Resilience ไม่ใช่ระบบแยกเดี่ยว
Cybersecurity ถ้ามองเป็นเรื่อง Firewall หรือ Antivirus อย่างเดียว ผมคิดว่ามันแคบเกินไปแล้วครับ
เพราะต่อให้ป้องกันดีแค่ไหน เราก็ไม่ควรออกแบบระบบโดยตั้งสมมติฐานว่า
“ไม่มีวันโดน”
แนวทางของ Cybernetics+ จึงแบ่งการป้องกัน Infrastructure ออกเป็นสามส่วนหลัก
→ Protect the Server
→ Secure Access
→ Ensure Recovery
ผมชอบมองมันเป็นสามคำถามง่าย ๆ
เราป้องกัน Server ดีพอหรือยัง?
คนที่เข้าระบบ เป็นคนและอุปกรณ์ที่ควรเข้าได้จริงหรือเปล่า?
และสุดท้าย ถ้าทุกอย่างที่ป้องกันไว้ยังพลาด เรากลับมาได้ไหม?
Layer 1: Protect the Server
เริ่มจากลดโอกาสที่ Production จะถูกโจมตีตั้งแต่ต้น
บริการ Server Layer Protection ของ Cybernetics+ ครอบคลุมตั้งแต่ Anti-Malware, Host Firewall, System Hardening, Database Least Privilege และ Monitoring ไปจนถึง Threat Monitoring, Vulnerability Remediation และ Patch Management ตามระดับบริการ
เพราะถ้าป้องกันเหตุได้ตั้งแต่ก่อนเกิด Recovery ก็ไม่ต้องทำงานครับ
Layer 2: Secure Access
บางครั้งปัญหาไม่ได้เริ่มจาก Server เลย
แต่เริ่มจาก User Account หรือ Device ที่ไม่ควรเข้าระบบได้
Cybernetics+ จึงใช้แนวคิด Zero Trust ผ่าน Cato Networks SASE และ ZTNA เพื่อควบคุม Identity, Device Posture และสิทธิ์ในการเข้า Application พร้อมมาตรการอย่าง SWG, IPS, Anti-Malware และ Anti-Phishing
หลักคิดง่าย ๆ คือ อย่าให้ User หรือ Device เข้าถึงอะไรเกินกว่าที่จำเป็น
Layer 3: Ensure Recovery
ชั้นสุดท้ายคือคำถามที่เราคุยกันมาตลอดบทความนี้ครับ
ถ้าวันหนึ่งระบบโดนจริง เราจะกลับมาได้ไหม
Cybernetics+ มี Disaster Recovery Protection อยู่สามระดับ
Cybernetics+ DR Service | แนวทาง | ราคาเริ่มต้น* |
Cold Site | Immutable Off-site Backup และสร้าง Environment เมื่อเกิด Disaster | 36,000 บาท/Environment/ปี |
Warm Site | Standby Infrastructure + Periodic Replication | 72,000 บาท/Environment/ปี |
Hot Site | Near Real-Time Replication + Automated/Semi-Automated Failover | 108,000 บาท/Environment/ปี |
บริการทั้งสามระดับไม่ได้ต่างกันแค่ราคา แต่ต่างกันที่ระดับความพร้อม Infrastructure, การ Replicate ข้อมูล และความเร็วที่ต้องการในการ Recover ระบบ
*ราคาเป็นราคาเริ่มต้นตาม Service Catalog โดยขอบเขตจริงยังขึ้นกับ Architecture, ปริมาณข้อมูล, จำนวน Environment และ RTO/RPO ที่ต้องการครับ
DR ที่ดี ไม่จำเป็นต้องเป็น DR ที่แพงที่สุด
สุดท้ายแล้วผมคิดว่า Cold, Warm หรือ Hot Site ไม่มีตัวไหน “ดีที่สุด” แบบลอย ๆ ครับ มีแต่ตัวที่เหมาะหรือไม่เหมาะกับธุรกิจนั้น
ถ้าระบบหนึ่งหยุดได้หนึ่งวันโดยแทบไม่มีผลกระทบ การเอางบไปทำ Hot Site อาจไม่จำเป็น
แต่ถ้าระบบขายหยุดหนึ่งชั่วโมงแล้วบริษัทสูญเสียรายได้จำนวนมาก การใช้ Backup วันละครั้งอย่างเดียวก็อาจเสี่ยงเกินไป เพราะฉะนั้นก่อนลงทุน DR ลองตอบคำถามเหล่านี้ให้ได้ก่อนครับ
ระบบไหนสำคัญที่สุด?
ระบบนั้นหยุดได้นานเท่าไร?
ยอมเสียข้อมูลย้อนหลังได้กี่นาทีหรือกี่ชั่วโมง?
Backup ที่มีอยู่ Restore ได้จริงหรือเปล่า?
และคำถามสุดท้ายที่ผมคิดว่าสำคัญมาก
เราเคยลองกู้มันกลับมาจริง ๆ หรือยัง?
เพราะวันที่เกิด Ransomware หรือ Disaster จริง ไม่ควรเป็นวันแรกที่ทีม IT ได้เปิด Recovery Runbook อ่านครับ
Cybernetics+: From Protection to Recovery
พวกเราจะช่วยองค์กรออกแบบ Cyber Resilience ตั้งแต่การป้องกัน Infrastructure การควบคุม Access ไปจนถึงการ Recover ระบบเมื่อเกิด Cyberattack หรือ Disaster
บริการที่เกี่ยวข้องประกอบด้วย
Server Layer Protection
Cato ZTNA & SASE
BCP / Disaster Recovery Protection
Cold, Warm และ Hot Site
Immutable Off-site Backup
Business Impact Analysis และ RTO/RPO
Recovery Runbook
Annual DR Drill
Vulnerability Assessment
Penetration Testing
Cybersecurity Project Management
ทั้งหมดนี้อยู่ภายใต้แนวคิดเดียวกันครับ
ป้องกันให้ดีที่สุด จำกัดความเสียหายให้เร็วที่สุด และถ้าวันหนึ่งเกิดเหตุขึ้นจริง ต้องกลับมาทำธุรกิจต่อให้ได้